大数据 Hadoop-3.2.1 分布式集群部署
大数据 Hadoop-3.2.1 分布式集群部署
chify集群架构总览
本次部署采用 4 台 CentOS 7 虚拟机,各节点角色分配如下:
  graph TB
    subgraph hadoop01["hadoop01 - NameNode"]
        NN["NameNode
HDFS 主节点"]
    end
    subgraph hadoop02["hadoop02 - Secondary NameNode"]
        SNN["Secondary NameNode
HDFS 辅助节点"]
    end
    subgraph hadoop03["hadoop03 - ResourceManager"]
        RM["ResourceManager
YARN 资源管理"]
    end
    subgraph hadoop04["hadoop04 - HistoryServer"]
        HS["JobHistory Server
任务历史记录"]
    end

    NN -->|"HDFS 数据块管理"| DN1["DataNode (hadoop01)"]
    NN -->|"HDFS 数据块管理"| DN2["DataNode (hadoop02)"]
    NN -->|"HDFS 数据块管理"| DN3["DataNode (hadoop03)"]
    NN -->|"HDFS 数据块管理"| DN4["DataNode (hadoop04)"]
    RM -->|"任务调度"| NM1["NodeManager (hadoop01)"]
    RM -->|"任务调度"| NM2["NodeManager (hadoop02)"]
    RM -->|"任务调度"| NM3["NodeManager (hadoop03)"]
    RM -->|"任务调度"| NM4["NodeManager (hadoop04)"]
一. 服务器准备
VMware 里安装四台 CentOS 7,需要配置如下内容
- 服务器开启开机自动联网和设置静态 IP
- 修改主机名且配置 hosts 映射
- 关闭防火墙和 selinux
- 设置 4 台机器相互之间的 ssh 互信免密登陆
服务器开机自动联网和静态 IP
编辑网卡设备 vi /etc/sysconfig/network-scripts/ifcfg-ens33
1 | # 将 ONBOOT 设置为 YES |
注:xshell 建立完连接后可能会卡在 [To escape to local shell, press 'Ctrl+Alt+]'] 无法操作,通过以下方式可解决此问题:vi /etc/ssh/sshd_config,找到 UseDNS yes 修改为 UseDNS no
1 | # 重启 sshd |
修改主机名、配置 Hosts
- 修改主机名
1 | # 设置主机名称,四台服务器依次为 hadoop01、hadoop02、hadoop03、hadoop04 |
- hosts 域名 IP 映射配置
vi /etc/hosts 添加如下配置:
1 | 192.168.44.129 hadoop01 |
关闭防火墙和 selinux
- 防火墙
1 | systemctl status firewalld |
- selinux
1 | vi /etc/selinux/config |
设置 ssh 互信免密登陆
参考其他文章 -> Linux SSH免密登陆
二. Hadoop 安装
Hadoop 是基于 Java 平台实现的,首先需要有 JDK 环境,然后再去搭建 Hadoop 集群,需要做如下配置:
- 配置 JDK
- 下载安装 Hadoop
- 修改 Hadoop 集群配置文件
scp同步每台机器的 Hadoop 环境变量配置和软件目录- 初始化 Hadoop 的 NameNode
- 启动 Hadoop
- 验证 Hadoop
安装 JDK
需要每台服务器都装上 JDK,具体 JDK 如何安装可参考此文章 -> Linux下JDK、Eclipse安装与配置简记
安装 Hadoop
至 Hadoop 官网 下载 Hadoop 软件包,然后使用 xftp 上传至服务器 hadoop01 中(hadoop02-04 在修改完集群配置文件后使用 scp 命令从 hadoop01 拷贝过去即可),解压软件至 /opt,然后配置环境变量,新增 vim /etc/profile.d/myself_env.sh 文件,添加如下内容:
1 | export JAVA_HOME=/opt/jdk1.8.0_261 # 需要配置自己的JDK目录 |
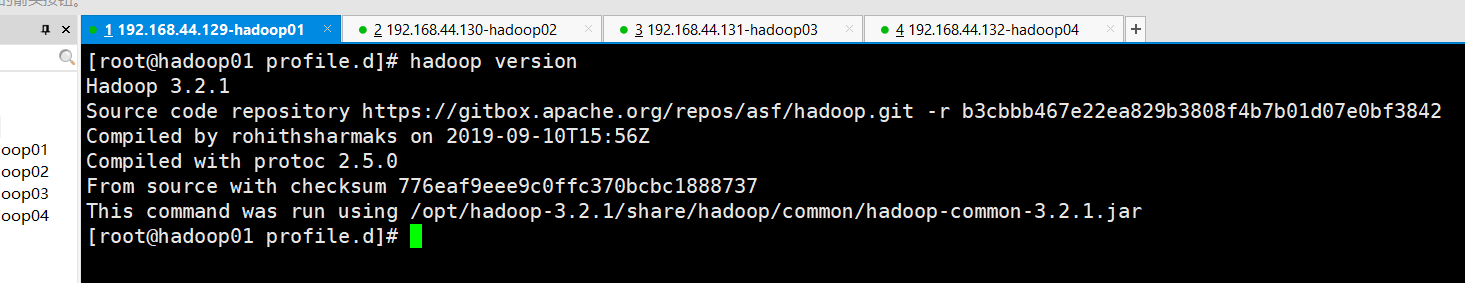
更新环境变量后使用 hadoop version 查看是否安装成功,显示如下图则说明安装成功。
Hadoop 集群配置文件修改
进入 Hadoop 软件目录 /opt/hadoop-3.2.1/etc/hadoop 下,修改如下几个配置文件
hadoop-env.sh
1 | export JAVA_HOME=/usr/java/jdk1.8.0_111 |
JAVA_HOME:指定 JDK 路径;HDFS_NAMENODE_USER:指定操作 NameNode 进程的用户;HDFS_DATANODE_USER:指定操作 DataNode 进程的用户;HDFS_SECONDARYNAMENODE_USER:指定操作 Secondary NameNode 进程的用户。这三个配置是 Hadoop 3.x 为了提升安全性而引入的。日志信息默认在${HADOOP_HOME}/logs中,也可以自行配置目录。
core-site.xml
1 | <configuration> |
hdfs-site.xml
1 | <configuration> |
mapred-site.xml
1 | <configuration> |
yarn-site.xml
1 | <configuration> |
workers
1 | hadoop01 |
scp 拷贝数据至 hadoop02-04 服务器
注:需要上面的集群配置文件修改完后才可再进行拷贝。
1 | # 拷贝环境变量文件至三台从节点 |
初始化 NameNode
初始化目录:
1 | bin/hdfs namenode -format |
注:首次启动要 format,如果想重新 format 的话,所有机器的 data_file 目录都需要删除,否则会出问题。
启动 Hadoop
- 启动/关闭 HDFS
1 | /opt/hadoop-3.2.1/sbin/start-dfs.sh # 或 stop-dfs.sh |
- 启动 YARN
1 | /opt/hadoop-3.2.1/sbin/start-yarn.sh # 或 stop-yarn.sh |
- 启动/关闭历史服务
1 | mapred --daemon start historyserver # 或 stop historyserver |
验证 Hadoop
NameNode 页面
http://hadoop01:9870/Secondary NameNode 页面
http://hadoop02:9868/YARN 页面
http://hadoop03:8088/JobHistory 页面
http://hadoop04:19888/日志聚集页面
http://hadoop04:19888/jobhistory/logs
注:宿主机电脑的 hosts 文件也需要加上 hadoop01-04 的映射配置
三. 时间同步
如果服务器可以连接互联网且本身会自动同步时间,则可以不用配置。但是如果是内网无法连接互联网或者无法同步时间的时候,则需要配置下 hadoop01-04 这几台服务器之间的时间同步,否则时间久了就会导致时间偏差,导致集群执行任务时时间不同步。尤其是如果后面还需要部署 HBase 的话,时间同步是必须要做的,否则一旦时间出现误差,将会出现大问题。
首先先设置好 hadoop01-04 所有机器的时区:timedatectl set-timezone Asia/Shanghai
可以连接互联网时的配置
可以连接互联网,但是服务器默认没有去同步时间时,可以先 yum 安装 ntpd 服务,然后配置所有机器与互联网上的时间服务器进行时间同步。
1 | # 安装 ntpd 时间同步服务 |
内网配置 hadoop01-04 同步时间
以 hadoop01 为时间同步服务器,其他服务器以 hadoop01 时间为准进行同步,修改 hadoop01 的 /etc/ntp.conf 文件(vim),修改如下内容:
1 | # 授权 hadoop01 所在网段上的所有机器可以从 hadoop01 查询和同步时间 |
修改 hadoop01 下 /etc/sysconfig/ntpd 文件(vim),设置硬件与系统时间进行同步,添加一行:SYNC_HWCLOCK=yes 保存,systemctl restart ntpd 重启时间服务。
进入 hadoop02-04 服务器,添加定时任务,每隔一段时间去同步 hadoop01 时间,如下:
1 | # 编辑定时任务 |
至此,hadoop02-04 服务器就会按规定的时间定期去同步 hadoop01 的时间,大功告成。
四. 常见问题排查
问题 1:NameNode 无法启动
现象: 执行 start-dfs.sh 后,jps 只显示 DataNode,没有 NameNode。
排查步骤:
- 检查日志文件
${HADOOP_HOME}/logs/hadoop-*-namenode-*.log - 常见原因:
data_file目录下存在旧的current目录,说明之前 format 过。删除所有节点的data_file目录后重新 format:
1 | rm -rf /opt/hadoop-3.2.1/data_file |
- 检查
hadoop-env.sh中JAVA_HOME路径是否正确
问题 2:节点之间 SSH 无法免密登陆
现象: scp 拷贝文件时仍需输入密码。
排查步骤:
1 | # 在 hadoop01 上检查公钥是否已分发 |
问题 3:DataNode 启动后立即退出
现象: jps 显示 DataNode 短暂出现后消失。
排查步骤:
- 检查
data_file目录的VERSION文件中的clusterID是否与 NameNode 的一致 - 不一致时,删除所有节点的
data_file目录,重新 format NameNode,再启动所有节点
问题 4:YARN 页面无法访问
现象: 访问 http://hadoop03:8088/ 无响应。
排查步骤:
- 确认
yarn-site.xml中yarn.resourcemanager.hostname配置为hadoop03 - 检查 ResourceManager 进程是否在运行:
jps | grep ResourceManager - 检查防火墙是否已关闭:
systemctl status firewalld
问题 5:systemctl 命令报错 command not found
现象: 在 CentOS 6 或精简版系统中,systemctl 命令不存在。
解决方案: 使用 service 命令替代:
1 | service ntpd start # 替代 systemctl start ntpd |